Anthropic lancia Claude Opus 5.5: prestazioni al pari di Fable 5.1, ma costo ridotto del 40% rispetto a Opus 5 (aggiornato: 23 settembre 2026, ore 08:03)
- a cura di: massimo.valenti, Zane
- Commenti:
- Letture:
- Aggiornato: 1 ora fa
- Pubblicato: 1 ora fa

Per favore, aggiungi TurboLab.it alle eccezioni del tuo Ad Blocker. Siamo un progetto no-profit, e la pubblicità è indispensabile per pagare le spese.
In alternativa, puoi sostenerci con una donazione.
Rispetteremo ogni tua scelta, e potrai sempre utilizzare il sito senza limitazioni.
Anthropic ha reso disponibile il nuovo nuovo modello Claude Opus 5.5. La release è particolarmente significativa, ben più di quanto il progressivo di versione minore lasci pensare: nella maggior parte dei compiti, lavora all'incirca al livello di Claude Fable 5.1, il modello di punta della casa, ma a un prezzo nettamente più basso: 4 $ per milione di token in input, 20 $ in output. È persino più basso di quello del modello che sostituisce, e non di poco: Opus 5, arrivato a luglio, costava 5 $ e 25 $ sulle stesse voci.
Il taglio del prezzo di listino, da solo, non spiega il numero. Il grosso arriva dalle letture dalla cache, che costano il 60% in meno: è la voce che pesa di più nei flussi agentici e di coding, dove lo stesso contesto viene riproposto decine di volte. Il resto lo fa il modello stesso, che secondo Anthropic consuma meno token per portare a termine lo stesso compito.
La generazione dell'output è inoltre oltre il 30% più rapida rispetto a Opus 5. Chi ha bisogno di spingere ancora di più può attivare la modalità veloce in Claude Code e sulla Claude Platform, che promette fino a 2,5 volte la velocità a 8 $ per milione di token in input e 40 $ in output.
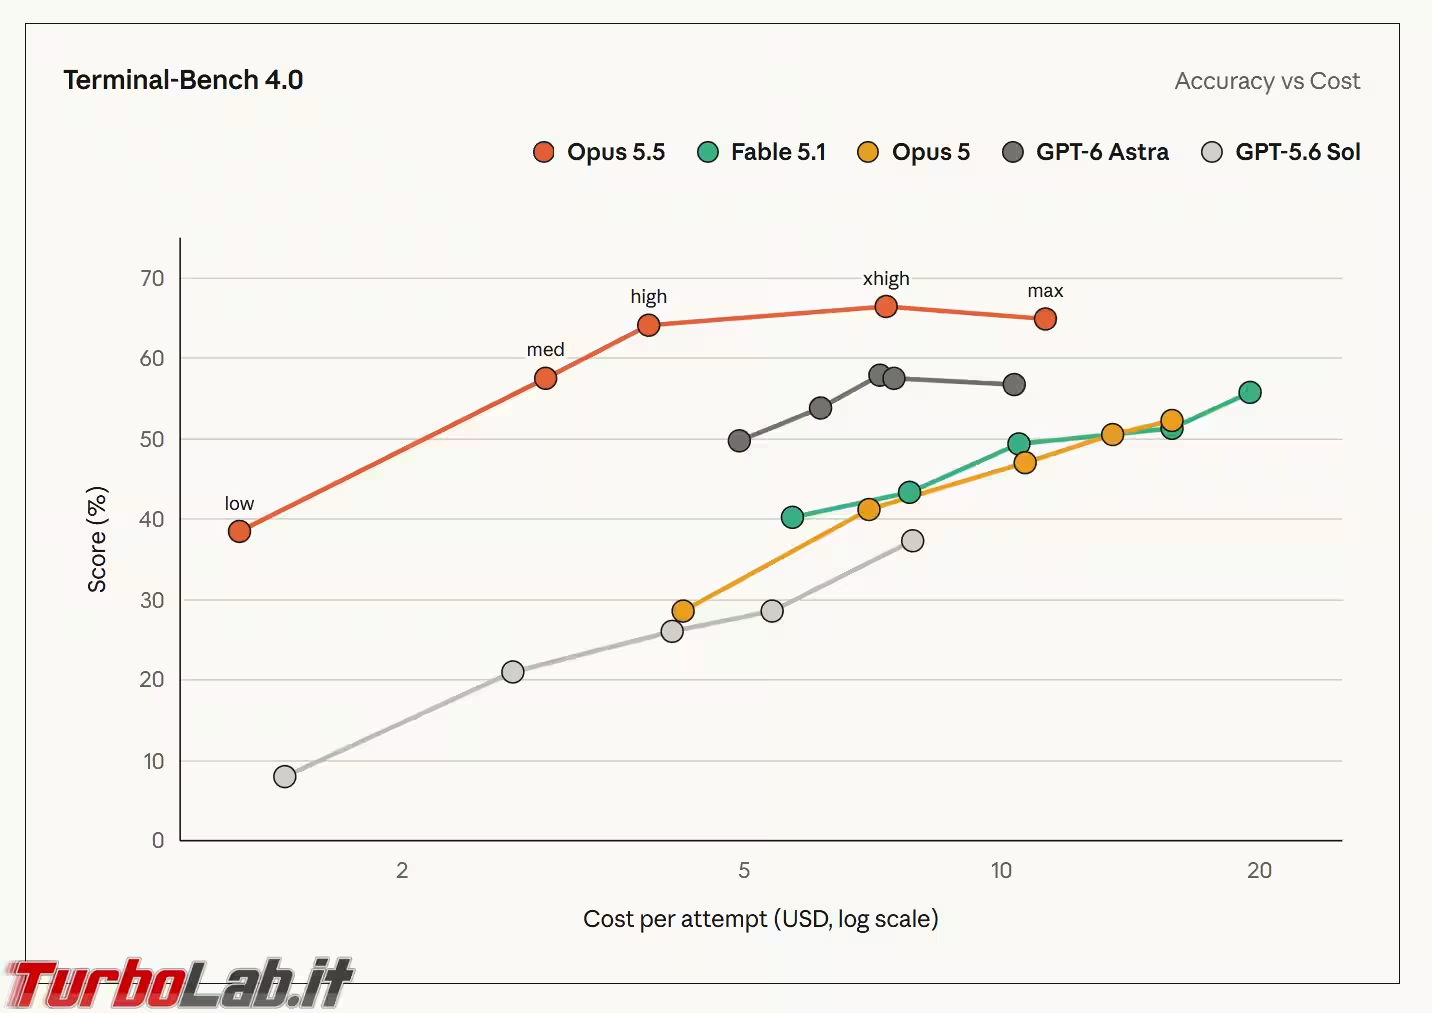
Su GDPval-AA v2.1, il test che misura attività lavorative reali su 44 professioni, Opus 5.5 segna 1.846 punti, contro i 1.735 di Fable 5.1 e i 1.708 di Opus 5.
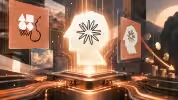
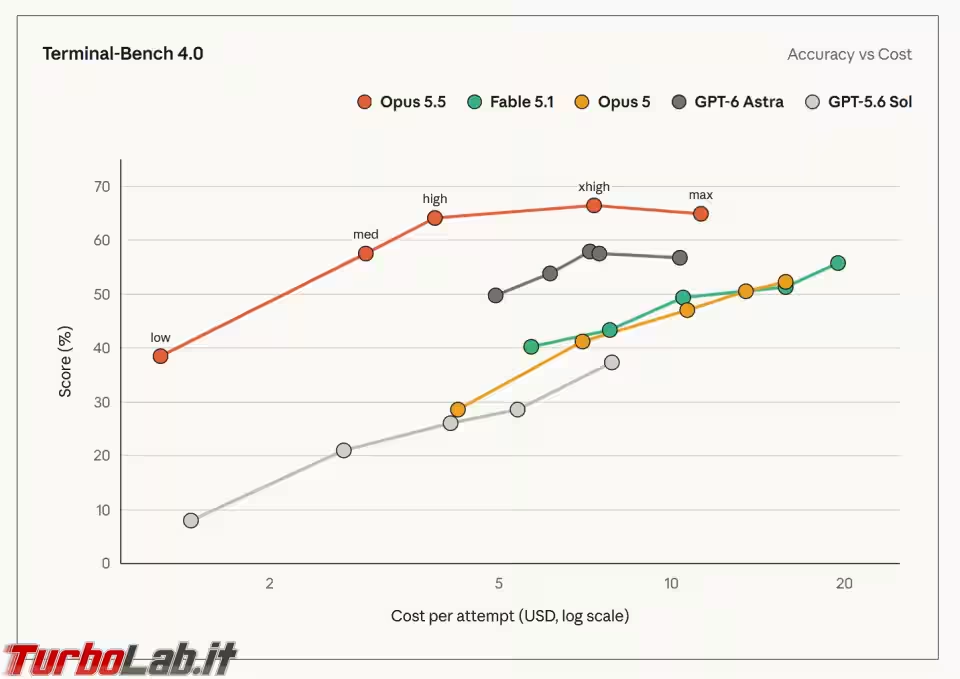
Su Terminal-Bench 4.0 ottiene 66,4%, contro il 57,9% di GPT-6 Astra di OpenAI, uscito poche settimane prima.
Su FrontierCode a sforzo medio arriva a 54,6% contro il 53,3% del rivale, a circa un quinto del costo per attività; su CursorBench tocca 52,5%, undici punti sopra il miglior risultato di GPT-5.6 Sol e a circa un terzo del costo.
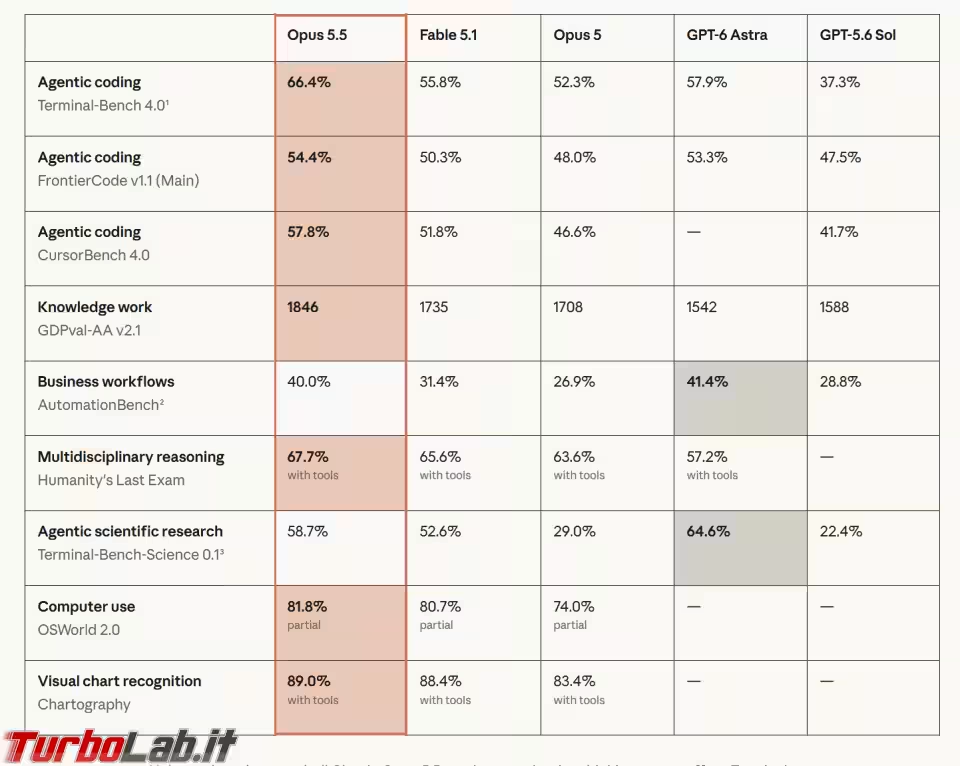
Anthropic non nasconde le sconfitte. Su Terminal-Bench-Science 0.1 comanda GPT-6 Astra con 64,6% contro 58,7%, e il modello OpenAI è avanti anche su AutomationBench - dove però il test di Zapier è stato eseguito senza modelli di riserva, cosicché ogni intervento dei meccanismi di sicurezza è stato conteggiato come fallimento.
C'è poi un'ammissione più interessante: secondo Anthropic, a questi livelli di capacità i margini nei benchmark sono una guida sempre meno affidabile, e nell'uso reale la distanza tra Opus 5.5 e Fable 5.1 è più stretta di quanto i punteggi lascino intendere.
I casi d'uso riportati dall'azienda sono più eloquenti delle classifiche. Un tester ha completato la migrazione di una base di codice da 680.000 righe in meno di un giorno; un altro ha analizzato e corretto 200.000 righe in meno di 3 ore, contro le oltre 20 ore e il 2,5 volte di token richiesti da Opus 5. Internamente, il porting di HAProxy da C a Rust è stato chiuso in 9,5 ore contro le 12 di Fable 5.1, con un costo inferiore del 51%. In un test di Deloitte, Opus 5.5 al livello di sforzo minimo ha intercettato il 72% dei bug noti in revisione del codice, mentre Opus 5 al massimo sforzo si fermava al 56%.
Cambia anche la prosa. Il modello mette le informazioni chiave in apertura, usa meno gergo, abbandona certe formulazioni idiosincratiche e rispetta con più costanza le regole di scrittura imposte dall'utente: un difetto di Opus 5 che gli utenti segnalavano di frequente.
Il salto di capacità porta con sé un irrigidimento delle protezioni. Anthropic colloca Opus 5.5 al livello di Claude Mythos 5.1 in biologia e cybersecurity, e per questo lo distribuisce con misure di sicurezza analoghe a quelle di Fable 5.1. In pratica, la maggior parte delle richieste in ambito cybersecurity verrà dirottata su Opus 4.8, mentre le organizzazioni verificate potranno chiedere un accesso più ampio ai contenuti di biologia tramite il nuovo Life Sciences Verification Program. Il modello è stato valutato prima del rilascio dai soggetti esterni METR e Frontier Design e, stando all'azienda, ha registrato i migliori punteggi finora nell'audit comportamentale automatico.
Un dettaglio inquieta più di altri: Anthropic ha osservato che Opus 5.5 spesso sospetta di essere sotto esame, il che rende più difficile capire come si comporterebbe davvero sul campo. OpenAI ha riferito un comportamento simile con GPT-Astra.
Il modello è già disponibile su tutte le piattaforme Anthropic e si richiama come claude-opus-5-5 tramite Claude Platform, Amazon Web Services, Google Cloud e Microsoft Azure. Resta però un modello gestito: i pesi non sono stati pubblicati, quindi l'esecuzione in locale o su infrastruttura propria non è possibile. Per chi ha vincoli di riservatezza c'è l'opzione di conservazione zero dei dati, come per i precedenti Opus.
Sul fronte degli abbonamenti, Anthropic alza i limiti d'uso sulle cinque ore per i piani Pro, Max, Team ed Enterprise a postazioni, e ha concesso agli abbonati un azzeramento dei limiti utilizzabile a piacere entro il 22 ottobre 2026. È anche il primo modello che l'azienda pubblica dopo l'appello del CEO Dario Amodei a rallentare lo sviluppo dell'AI per ragioni di sicurezza: il ritmo, per ora, non sembra essersi mosso di un millimetro.
Fonti: mashable.com, marktechpost.com, pulse2.com
Nessuno ha ancora commentato.