Google Gemini 4 Hydrogen è ufficiale: il modello "quotidiano" per gli agenti AI, a 1,50 $ per milione di token (aggiornato: 12 novembre 2026, ore 22:43)
- a cura di: massimo.valenti
- Commenti:
- Letture:
- Aggiornato: 7 ore fa
- Pubblicato: un attimo fa

Per favore, aggiungi TurboLab.it alle eccezioni del tuo Ad Blocker. Siamo un progetto no-profit, e la pubblicità è indispensabile per pagare le spese.
In alternativa, puoi sostenerci con una donazione.
Rispetteremo ogni tua scelta, e potrai sempre utilizzare il sito senza limitazioni.
Non il modello più potente della famiglia, ma quello da usare tutti i giorni. Così Google presenta Gemini 4 Hydrogen, rilasciato ieri, 12 novembre 2026. È pensato per i flussi di lavoro agentici, cioè i compiti in cui l'AI pianifica ed esegue da sola una sequenza di azioni. Arriva poche settimane dopo i modelli di punta Gemini 4 Carbon e Gemini 4 Argon, con un ruolo diverso. Per sviluppatori e power user la domanda è concreta: su quale modello conviene costruire i propri flussi di automazione?
Il post di lancio porta la firma di Koray Kavukcuoglu, SVP di Google DeepMind e Chief AI Architect, e definisce Hydrogen «il nostro modello di riferimento quotidiano per i flussi di lavoro agentici». La documentazione di Google Cloud insiste sullo stesso concetto: «intelligenza all'avanguardia, con velocità ed efficienza, per la programmazione di tutti i giorni e i flussi di lavoro agentici aziendali».
La divisione dei compiti è netta. Carbon e Argon si occupano del ragionamento lungo e articolato, comprese le scelte architetturali. Hydrogen scrive codice, esegue i test e verifica le modifiche. Google tiene però a precisare che non è un semplice assistente di un modello più grande: deve saper lavorare anche in autonomia. Chiamare "quotidiano" un modello agentico non è un dettaglio di marketing, ma un segnale: Google vuole che l'agente autonomo diventi la modalità d'uso normale, non l'esperimento per pochi.
Il listino è lineare: 1,50 $ per milione di token in input e 7,50 $ per milione in output, senza scaglioni su tutta la finestra di contesto. Il limite è unico, 1.048.576 token, e comprende input e output. Nell'output rientrano anche il ragionamento interno, le chiamate di funzione e la risposta finale. Il limite vale per la GenerateContent API, la Interactions API e la Chat Completions API compatibile con OpenAI.
Un singolo segmento genera fino a 65.536 token di output. Per andare oltre si usano le "long decodes" della Interactions API, tramite continuation_token o background=true. Attenzione però: continuation_token funziona solo con l'API v1beta1, che comunque è quella usata di default dall'SDK Google Gen AI.
Chi migra da modelli precedenti deve rivedere qualche abitudine. I livelli di ragionamento sono quattro: LOW, MEDIUM, HIGH (il default) e il nuovo XHIGH. Impostare thinking_budget o thinking_level="MINIMAL" restituisce un errore HTTP 400. I valori personalizzati di temperature, top_p e top_k vengono semplicemente ignorati. Il caching del contesto è solo implicito, con una soglia minima di 4.096 token. Tra gli input accettati, oltre a PDF e testo semplice, compaiono anche i file di Microsoft Office e OpenDocument.
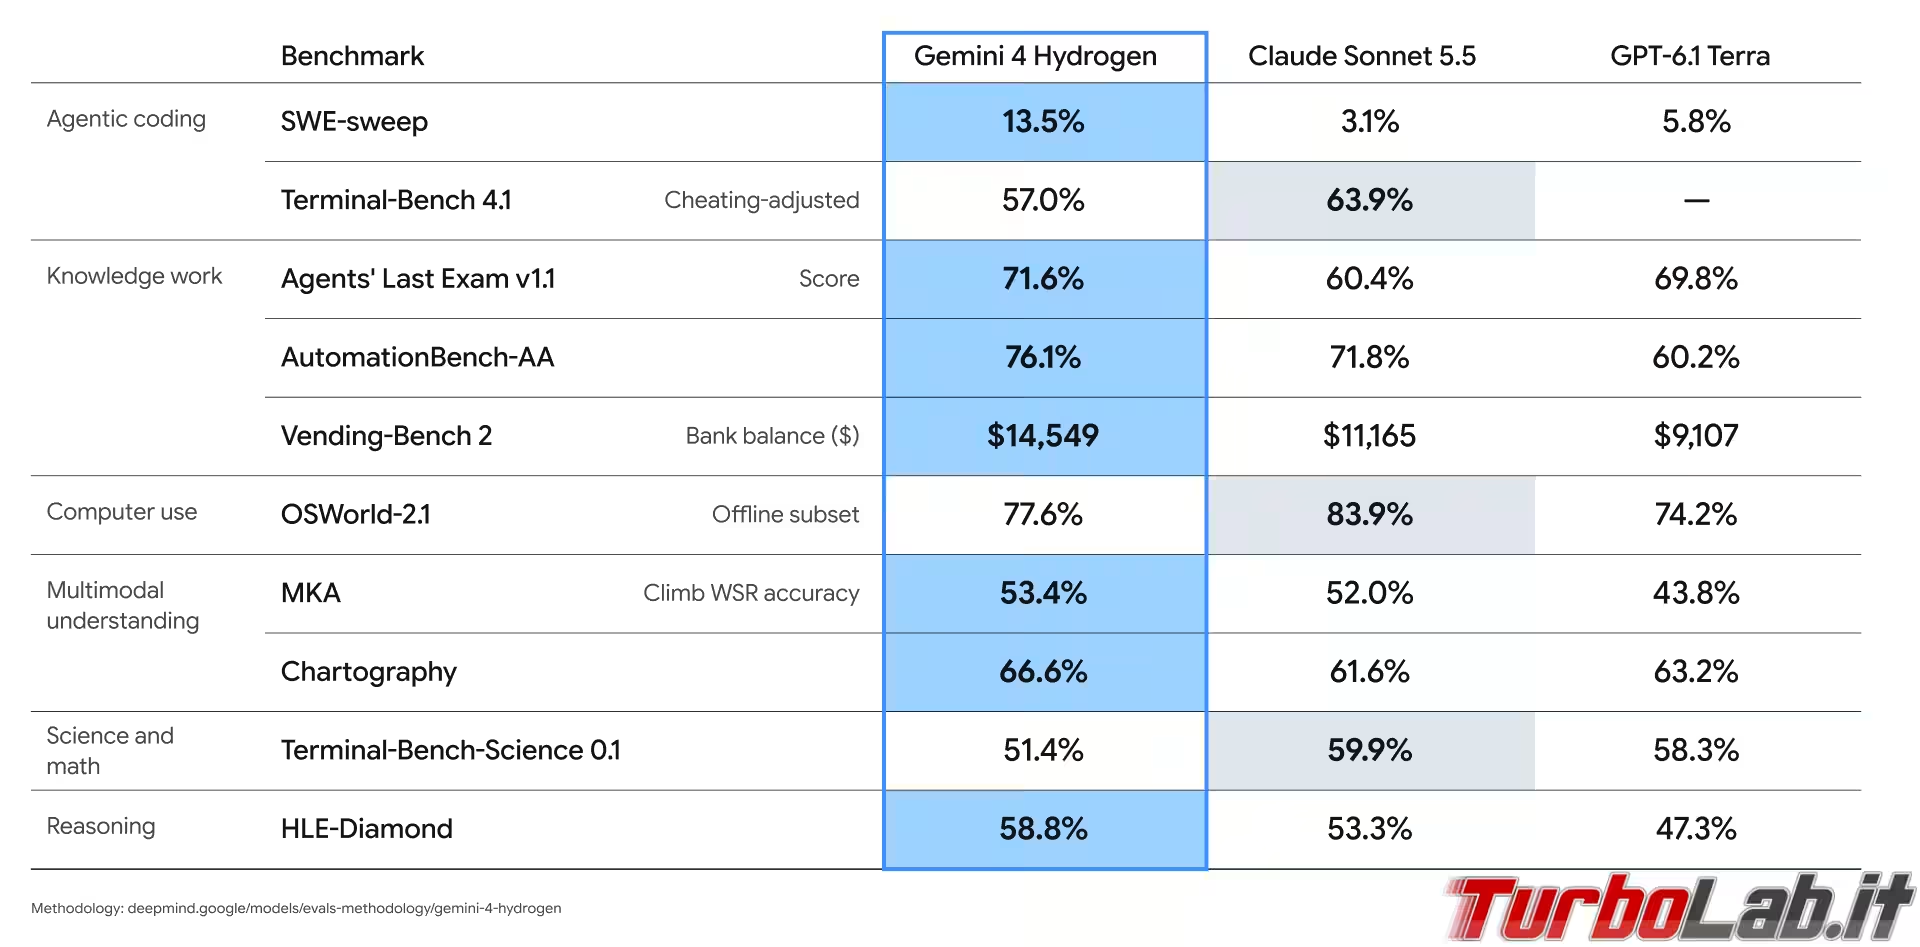
Quasi tutti i dati prestazionali arrivano da Google. Secondo l'azienda, Hydrogen completa i compiti 2,5 volte più in fretta di Gemini 3.8 Flash al livello di ragionamento predefinito. Su Terminal-Bench 4.1 ottiene il 57%, contro il 18,2% del predecessore, e il 52,3% su Vals Tax Agent Bench. Google dichiara anche oltre cinque volte meno affermazioni inventate rispetto a Gemini 3.8 Flash. Promette inoltre fino all'81% in meno di iniziative non richieste nei compiti agentici. La probabilità di aggirare i limiti dei permessi quando un compito viene bloccato sarebbe fino a due volte inferiore.
Nel confronto con la concorrenza, i benchmark di Google collocano Hydrogen davanti a GPT 6.1 Terra e Claude Sonnet 5.5 nelle prove di conoscenza e multimodali. Resta invece leggermente indietro in scienze e matematica, nell'uso del computer e proprio su Terminal-Bench 4.1.
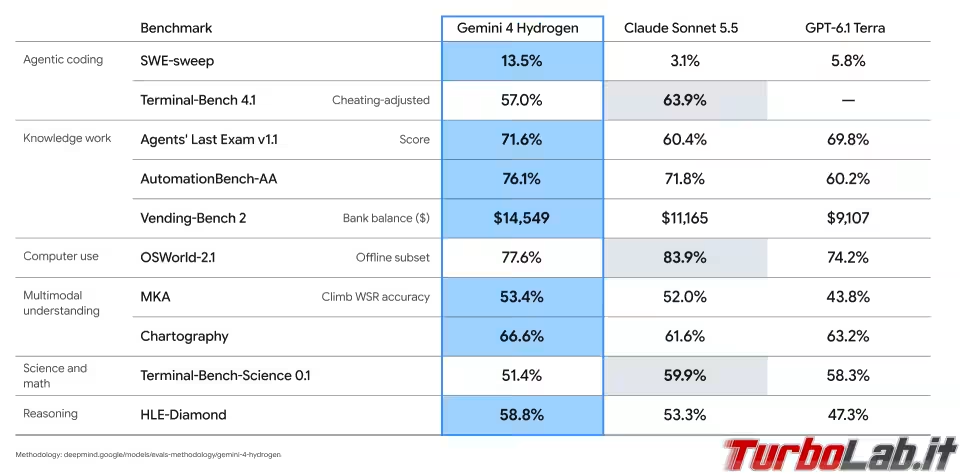
L'unica valutazione indipendente è quella di Artificial Analysis. Il suo Intelligence Index assegna a Hydrogen 51 punti con ragionamento HIGH e 54 con XHIGH. In quest'ultima configurazione è a un solo punto da Claude Sonnet 5.5 e GPT-6.1 Sol, entrambi al massimo livello di ragionamento. Su Terminal-Bench 4.0 e Terminal-Bench-Science 0.1, però, resta dietro a entrambi. Il livello extra ha un prezzo: XHIGH quasi raddoppia i token di output per guadagnare tre punti, e il costo medio per compito sale da 1,87 $ a 3,16 $.
Una novità interessante riguarda Google Antigravity. Il nuovo Orchestrator non usa più un unico modello dall'inizio alla fine della sessione. Passa invece dinamicamente da Carbon a Hydrogen: il primo affronta la pianificazione difficile, il secondo l'esecuzione rapida. Su Terminal-Bench 4.0, Google riferisce tassi di successo vicini a quelli di Carbon, con il 24% di quota consumata in meno e tempi di completamento ridotti del 19%. Sono però numeri dichiarati dal produttore e legati alla configurazione di Antigravity: non vanno confusi con il 57% ottenuto da Hydrogen su Terminal-Bench 4.1, che è un'altra versione del benchmark.
Hydrogen è disponibile in Google AI Studio, nella Gemini API, in Android Studio, nell'app Gemini, in Fogli Google, in Gemini for Business e in Antigravity. Quest'ultimo è riservato agli abbonati a pagamento Google AI Pro e Ultra. Il modello alimenta anche la Ricerca Google per tutti gli utenti, a livello globale. Chi usa gratuitamente l'app Gemini lo riceve tramite la selezione automatica del modello, solo «quando è appropriato per il prompt»: non c'è quindi garanzia di trovarlo sempre. Sul fronte terze parti, Cursor ne ha annunciato il supporto e Cognition lo ha già integrato in Devin Desktop e Devin CLI.
Sul fronte della sicurezza, la documentazione è ancora incompleta. Il Safety & Security Report completo arriverà «nei prossimi giorni», e i risultati interni pubblicati derivano solo da valutazioni automatiche, senza revisione umana né red teaming. Rispetto a Gemini 3.8 Flash, Google segnala una migliore sicurezza sui contenuti multimodali e un comportamento simile sul testo. I rifiuti ingiustificati invece aumentano, in particolare con i prompt multimodali. Un modello che alimenta già la Ricerca Google, e che agisce da solo nei flussi di lavoro, arriva dunque prima del proprio rapporto di sicurezza completo. Chi deve affidargli compiti con permessi reali farebbe bene ad aspettare di leggerlo.
Fonti: digitaltrends.com, aiweekly.co, docs.cloud.google.com
Nessuno ha ancora commentato.