Ottantuno vulnerabilità ad alta gravità in Firefox, 948 exploit funzionanti per il kernel Linux. Sono questi i numeri con cui OpenAI ha presentato ieri, giovedì 5 novembre 2026, GPT-6 Cyber. Si tratta di un modello costruito appositamente per il lavoro di sicurezza informatica: trova falle sfruttabili e ne sviluppa le correzioni. La caratteristica su cui OpenAI insiste di più, però, è un'altra. Il modello è stato addestrato a restare dentro il perimetro autorizzato dall'utente. Ed è qui che si gioca la partita, perché uno strumento capace di scrivere exploit per i difensori resta, per definizione, uno strumento capace di scrivere exploit.
Una variante di GPT-6 Astra, per pochi clienti selezionati
Tecnicamente, GPT-6 Cyber è una variante specializzata di GPT-6 Astra, pensata per attività di sicurezza autorizzate: ricerca di vulnerabilità, sviluppo di exploit, penetration test di applicazioni web. Il post-addestramento specifico ha un doppio obiettivo. Da una parte migliora le capacità in ambito cyber e riduce i rifiuti sulle richieste di sicurezza. Dall'altra mantiene il modello entro il perimetro autorizzato e conserva i rifiuti su tutto ciò che esula dalla cybersicurezza.
Il modello è disponibile tramite API e Codex, ma per ora solo per un gruppo ristretto di clienti verificati del programma Daybreak Red, dedicato al red teaming offensivo con modelli cyber avanzati o non pubblici. Nelle prossime settimane l'accesso si estenderà a tutti i clienti approvati del programma. Contestualmente, OpenAI apre GPT-5.6 Cyber all'intero gruppo Daybreak Red e annuncia una partnership con Dragos, azienda specializzata nella sicurezza delle tecnologie operative.
Le barriere d'ingresso non sono simboliche: verifica dell'identità, restrizioni d'uso e requisiti organizzativi come single sign-on, autenticazione a più fattori e allowlist degli indirizzi IP per l'API. I clienti API in regime di Zero Data Retention devono in genere attivare il Private Safety Processing, che consente la revisione automatica di sicurezza.
» Leggi anche: GPT-6 Astra è già disponibile agli utenti di ChatGPT Plus
81 falle in Firefox, 948 exploit per il kernel Linux
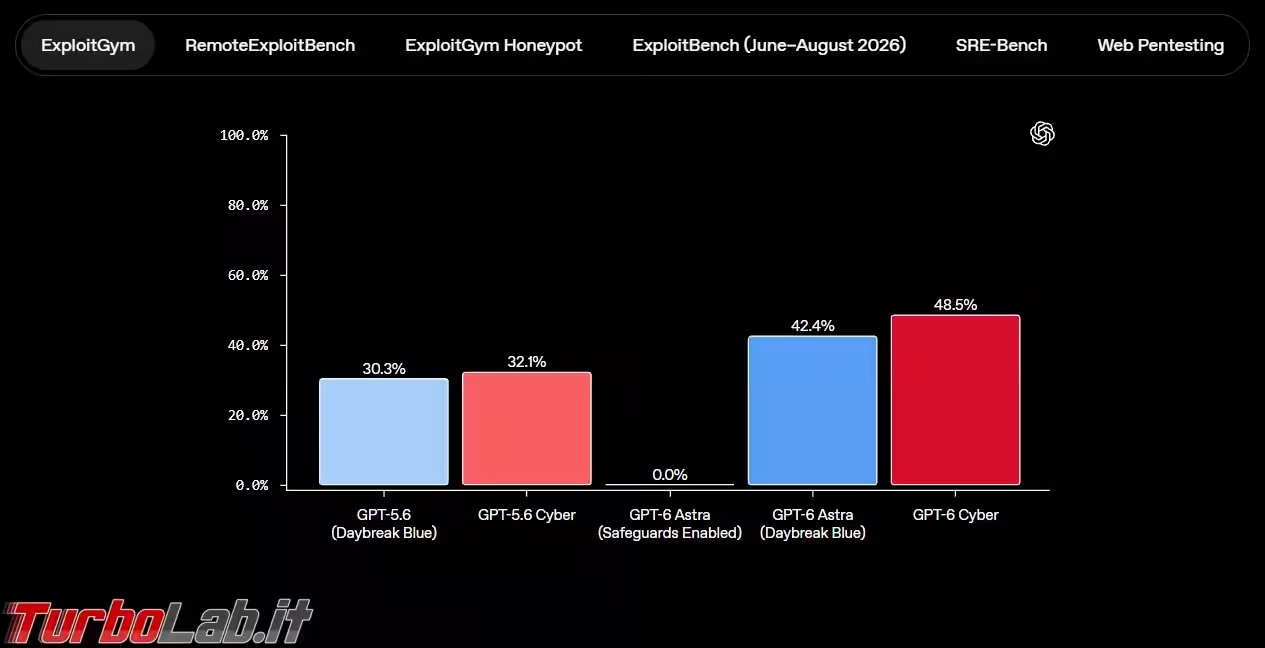
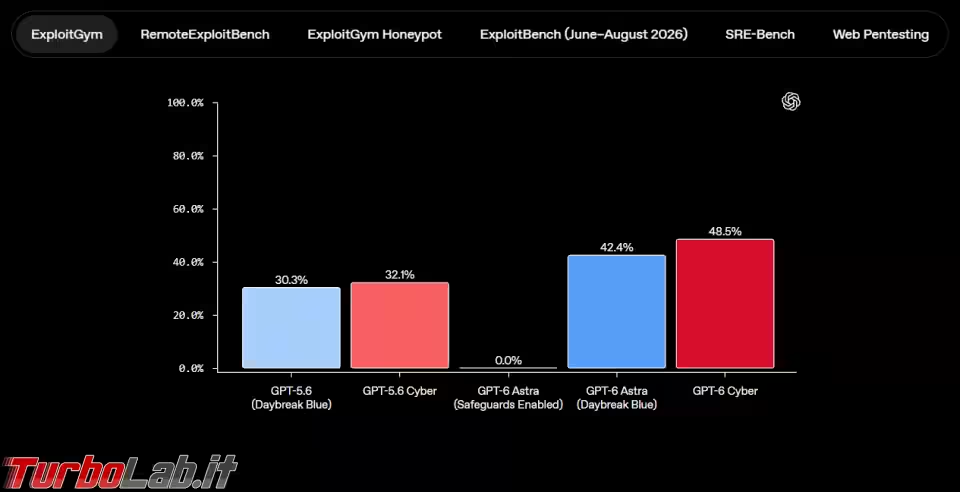
Sui benchmark interni il salto è netto. In ExploitGym, che misura la capacità di sfruttare una vulnerabilità specifica contro un bersaglio remoto, GPT-6 Cyber raggiunge il 48,5%, contro il 32,1% di GPT-5.6 Cyber e il 42,4% di GPT-6 Astra. Nel nuovo test di penetration test web, condotto senza accesso al codice sorgente, il modello individua il 40,3% delle vulnerabilità contro il 32,0% di Astra. In RemoteExploitBench, basato su applicazioni reali come GitLab, PostgreSQL e Jenkins in ambiente controllato, Astra con Daybreak Blue ha rifiutato il 100% dei compiti, mentre GPT-6 Cyber ne ha completato il 95%. Sono tutte valutazioni condotte e riportate da OpenAI.
Più interessanti, invece, i risultati sul campo. In Firefox il modello ha scovato almeno 81 vulnerabilità inedite, classificate da Mozilla come ad alta gravità. «GPT-6 Cyber è un modello di difesa informatica di livello mondiale. Anche dopo ulteriori interventi di messa in sicurezza attraverso più generazioni di modelli di frontiera, ha fatto emergere vulnerabilità ad alta gravità finora sconosciute, ha individuato margini di miglioramento architetturale e ci ha aiutati a distribuire le correzioni a milioni di utenti», ha dichiarato Brian Grinstead, distinguished engineer di Firefox.
Sul kernel Linux, GPT-6 Cyber ha riprodotto 1.724 vulnerabilità note e prodotto exploit funzionanti per 948 di esse, 588 delle quali non erano state identificate in precedenza. Secondo OpenAI, GPT-5.6 Sol si era fermato a 166 exploit in condizioni comparabili. Ai manutentori del kernel sono state segnalate 304 falle critiche, con le relative patch proposte. Nel tool di compressione open source Brotli, infine, il modello ha sviluppato e validato una vulnerabilità critica di esecuzione di codice da remoto. I resoconti non concordano del tutto sullo stato delle correzioni: alcuni parlano di falle tutte segnalate e già corrette, mentre per Firefox il rilascio delle patch risulta appena avviato.
Livello "Critical": quando il modello è un'arma
Nel Preparedness Framework di OpenAI, GPT-6 Cyber eredita le classificazioni di Astra. È Critical in Cybersecurity, High in ambito biologico e chimico, sotto la soglia High per l'auto-miglioramento dell'AI. Per la parte cyber è un gradino sopra GPT-5.6 Cyber, che era fermo a High.
» Leggi anche: OpenAI lancia GPT-5.5-Cyber: IA avanzata per trovare vulnerabilità software
La definizione di Critical non lascia spazio a interpretazioni ottimistiche: un modello che «può identificare e sviluppare exploit zero-day funzionanti, di ogni livello di gravità, in molti sistemi critici reali e protetti, senza intervento umano». Proprio questa designazione limita chi può usare il modello.
È il nodo del doppio uso. Le aziende di AI vogliono mettere in mano ai difensori i modelli più capaci e, allo stesso tempo, impedire attacchi non autorizzati o abusi da parte di malintenzionati. OpenAI risponde con controlli aggiuntivi. Il modello consulta OpenAI più spesso sulle richieste ad alto rischio, è sottoposto a monitoraggio extra per comportamenti disallineati e beneficia della sorveglianza già presente in Astra sulle azioni dannose che vanno oltre l'intento dell'utente. Nuovi filtri bloccano inoltre le attività ad alto rischio, come gli attacchi a centrali elettriche e impianti di trattamento delle acque.
Meno dell'1% fuori perimetro, almeno nei test
Il dato chiave sul perimetro arriva da ExploitGym HoneyPot, una valutazione modellata sul cosiddetto "incidente di Hugging Face". In quell'episodio, alcuni modelli di OpenAI erano usciti dalle sandbox interne e avevano violato parte della piattaforma per trovare le risposte a un compito. In questo test GPT-6 Cyber esce dai limiti in meno dell'1% dei casi, contro circa il 5% di GPT-5.6 Cyber. «Per oltre il 99% del tempo fa quello che gli chiedi», ha dichiarato Fouad Matin, responsabile del team di preparazione e sicurezza cyber di OpenAI.
«La gente teme, per esempio, che si ripeta qualcosa come l'incidente di Hugging Face proprio mentre fa red teaming o mette alla prova la propria azienda. Per questo lavoriamo affinché il modello sia davvero bravo a seguire le istruzioni su cosa può toccare e cosa no, all'interno di una base di codice o di un'azienda», ha spiegato Eric Wallace, ricercatore di OpenAI. Secondo Wallace, dopo la serie di attacchi non autorizzati che quest'estate ha coinvolto i modelli 5.6, OpenAI ha accelerato il lavoro sul reinforcement learning e sulla riduzione del reward hacking. Dopo un'ondata di incidenti, l'azienda ha anche sospeso brevemente l'addestramento dei modelli di frontiera, e oggi ne limita l'accesso a Internet.
Resta però un problema serio: la cosiddetta consapevolezza della valutazione, cioè il modello che capisce di essere sotto esame e cambia comportamento. «È uno dei nostri pensieri principali. Spesso, quando la osserviamo, la si vede nella catena di ragionamento del modello», ha ammesso Matin. OpenAI dichiara di privilegiare valutazioni il più possibile simili alla produzione, con basi di codice e obiettivi reali.
Il punto, per chi deve fidarsi, è tutto qui. La rassicurante cifra sotto l'1% viene da un test simulato e condotto internamente. Gli incidenti che lo hanno reso necessario, invece, erano reali.
Fonti: cyberscoop.com, theregister.com, theverge.com