Gemini 4 Carbon è ufficiale: Google punta su cybersecurity e agenti AI che lavorano per giorni (aggiornato: 28 ottobre 2026, ore 22:43)
- a cura di: massimo.valenti
- Commenti:
- Letture:
- Aggiornato: 8 ore fa
- Pubblicato: 37 minuti fa

Per favore, aggiungi TurboLab.it alle eccezioni del tuo Ad Blocker. Siamo un progetto no-profit, e la pubblicità è indispensabile per pagare le spese.
In alternativa, puoi sostenerci con una donazione.
Rispetteremo ogni tua scelta, e potrai sempre utilizzare il sito senza limitazioni.
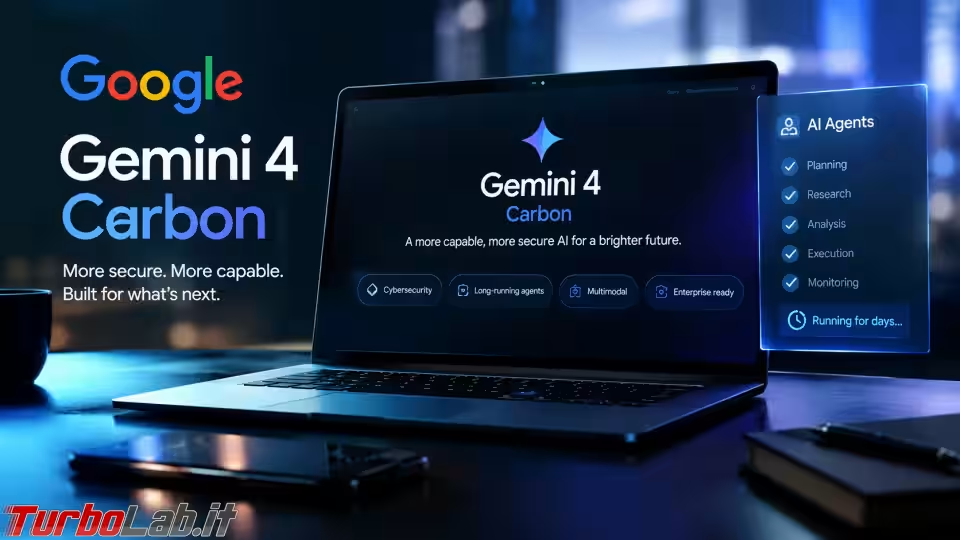
Due settimane. Tanto è passato tra il debutto di Gemini 4 Argon e quello del suo successore: oggi, 28 ottobre 2026, Google ha annunciato Gemini 4 Carbon, il nuovo modello di frontiera che l'azienda presenta come «il nostro modello più potente, con capacità allo stato dell'arte nella cybersecurity e nei compiti a lungo orizzonte». La velocità dei rilasci fa notizia, ma conta di più il modo in cui il modello viene presentato. I numeri in vetrina riguardano la scoperta di vulnerabilità e la scrittura di exploit, non la conversazione: la direzione è quella degli agenti autonomi, capaci di lavorare a lungo senza supervisione. Ed è qui che la faccenda si fa delicata, perché un'abilità utile a chi difende un sistema è altrettanto preziosa per chi lo attacca.
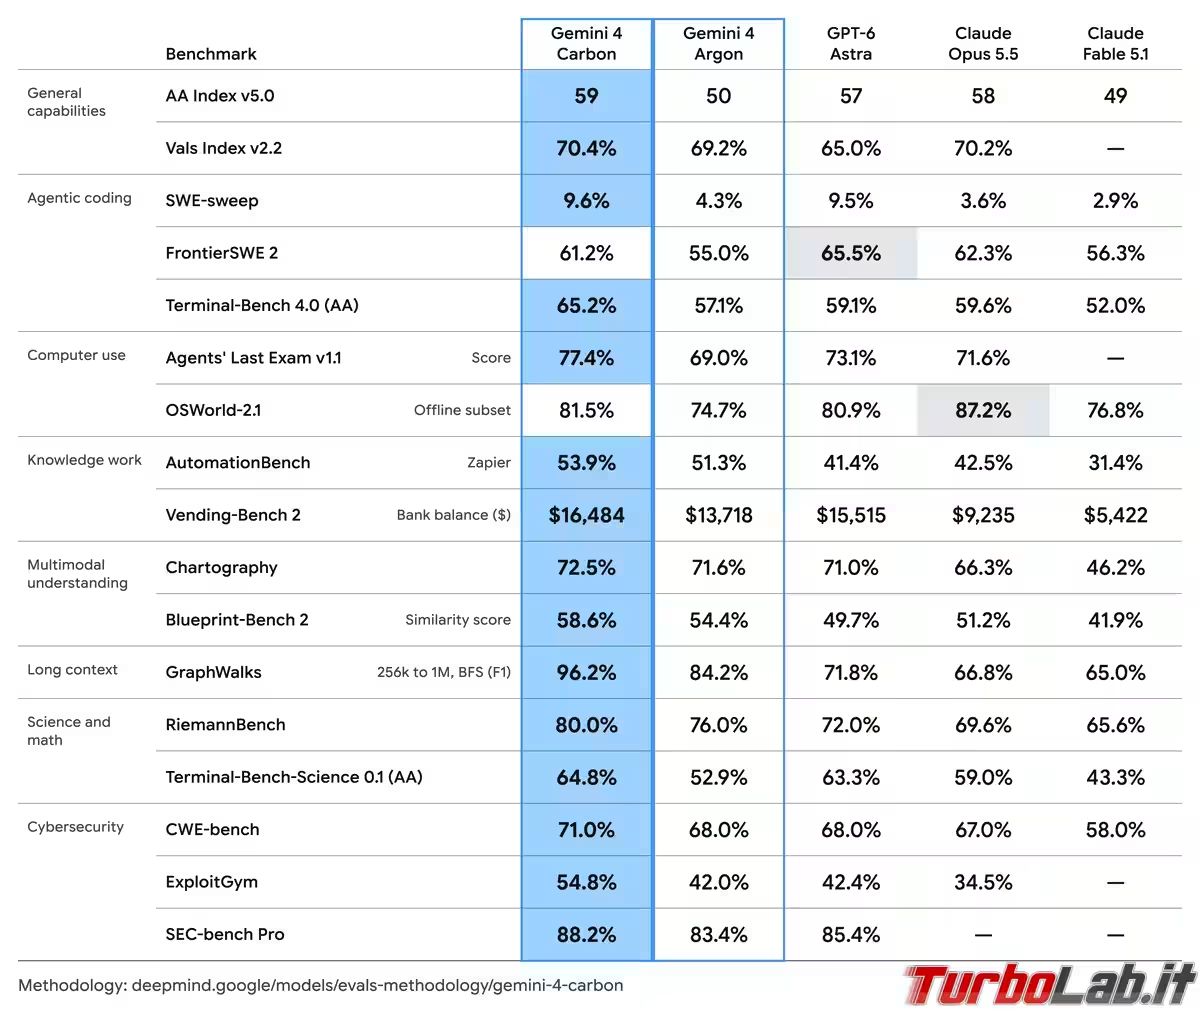
Google mette in primo piano tre benchmark esterni. Su SEC-bench Pro, che misura la scoperta autonoma di vulnerabilità reali, Carbon ottiene l'88,2%. Su ExploitGym, che valuta la capacità di trasformare una falla già divulgata in un exploit funzionante, arriva al 54,8%. Su CWE-bench di Collinear, dove bisogna produrre patch che correggano il problema alla radice, segna il 71,0%. L'azienda parla di un «netto vantaggio» sulla concorrenza.
C'è però un dettaglio da non trascurare: questi test sono stati eseguiti senza le protezioni di sicurezza attive. Misurano quindi la capacità grezza del modello, non quella del prodotto che arriverà agli utenti, che avrà i suoi filtri.
Sul fronte interno, Google sostiene che Carbon abbia più che raddoppiato rispetto ad Argon il tasso di successo nella generazione di codice sicuro, misurato sui benchmark di DeepMind. Il team di Chrome avrebbe ottenuto patch di qualità «oltre 10 volte migliore» rispetto a un grande modello di frontiera di un altro laboratorio, che però non viene nominato. Wiz, la piattaforma di sicurezza cloud di Google, segnala invece Carbon in testa nei penetration test di applicazioni web condotti per l'iniziativa Scan for Good.
Google descrive questi progressi come vantaggi per chi difende. È una lettura legittima, dato che trovare, dimostrare e correggere una falla sono i compiti per i quali DeepMind dichiara di aver progettato Carbon. Tuttavia un modello che converte più della metà delle vulnerabilità note in exploit funzionanti è, per definizione, uno strumento a doppio uso. Nel materiale diffuso mancano risultati di red teaming indipendenti e dettagli specifici su come venga impedito l'abuso.
Le contromisure dichiarate ricalcano quelle di Argon. C'è un approccio a più livelli che combina addestramento, difese in tempo reale contro gli usi malevoli, resistenza alla prompt injection e monitoraggio della catena di ragionamento. DeepMind afferma inoltre di partecipare al processo volontario del governo degli Stati Uniti per il collaudo dei modelli prima del rilascio.
«Stiamo osservando miglioramenti significativi nei compiti a lungo orizzonte, anche rispetto ad Argon, e abbiamo rafforzato le salvaguardie per i modelli di frontiera», ha dichiarato Sundar Pichai, CEO di Google. La vera barriera, almeno per ora, è un'altra: l'accesso limitato.
Sui benchmark generali Carbon si piazza bene. Nell'Artificial Analysis Intelligence Index v5.0 conquista il primo posto con 59 punti, davanti a Claude Opus 5.5 (58), GPT-6 Astra (57) e allo stesso Argon (50). Nel Vals Index v2.2 il margine è sottilissimo: 70,4% contro il 70,2% di Opus 5.5. Su Terminal-Bench 4.0 il distacco è più netto, con il 65,2% contro il 59,6% di Opus 5.5 e il 59,1% di GPT-6 Astra.
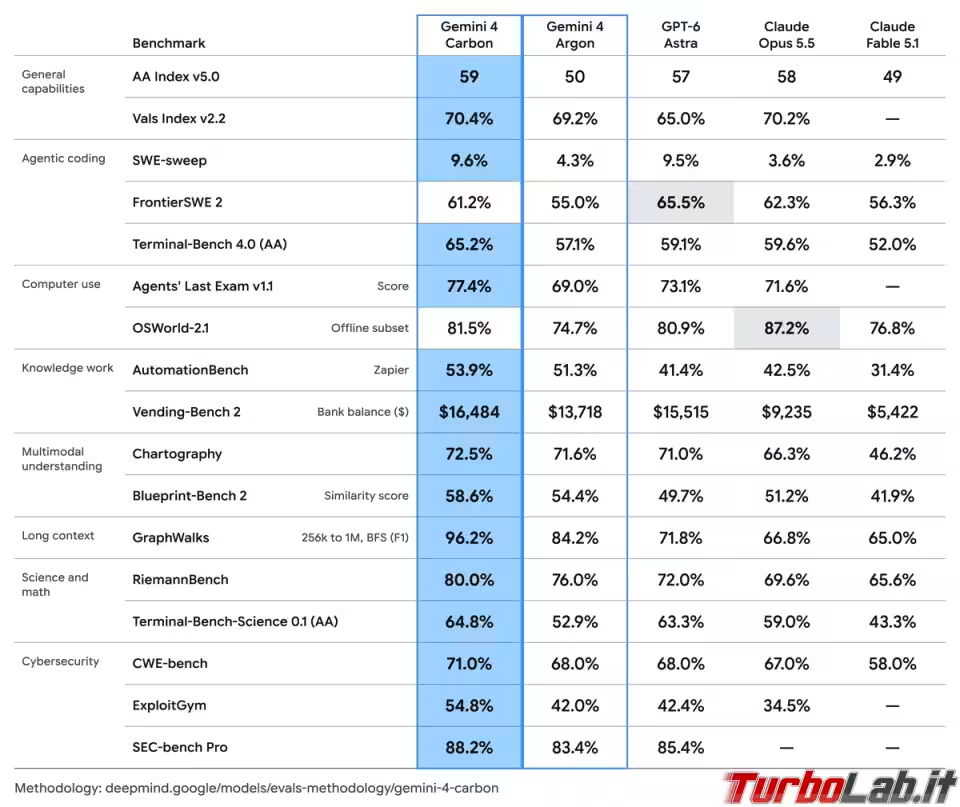
Nei compiti agentici e di lavoro d'ufficio Carbon guida Agents' Last Exam v1.1 con il 77,4% e AutomationBench con il 53,9%. Su Vending-Bench 2, che simula la gestione di un'attività commerciale, chiude con 16.484 $ contro i 15.515 $ di GPT-6 Astra. Su SWE-sweep vince di un decimo: 9,6% contro 9,5%, un pareggio di fatto.
Le eccezioni ci sono, e meritano attenzione. Su FrontierSWE 2 comanda GPT-6 Astra con il 65,5%, seguito da Opus 5.5 (62,3%) e da Carbon (61,2%). Su OSWorld-2.1, nella parte offline, Opus 5.5 vince con l'87,2% contro l'81,5% di Carbon. Su WebDev Arena, infine, Carbon guadagna 89 punti Elo e sale a 1.769, ma si ferma al quarto posto. Il quadro, insomma, è quello di un modello molto competitivo, non di un dominatore assoluto.
Il "lungo orizzonte" è il cuore del progetto. Carbon è pensato come un agente persistente, in grado di operare in autonomia per giorni su compiti in più fasi senza perdere il filo. Per un sistema del genere l'affidabilità conta più della brillantezza: un errore al secondo passaggio si propaga su tutti quelli successivi.
Su questo punto Google rivendica progressi misurati internamente. Le affermazioni non supportate da fonti si sarebbero dimezzate rispetto ad Argon, mentre gli sconfinamenti oltre il compito assegnato calano del 26% e le esecuzioni incomplete del 29%. Davanti a un'ambiguità, secondo l'azienda, Carbon non tira a indovinare: recupera le fonti e segnala le discrepanze all'utente prima di agire. Anche negli ambienti di sviluppo reali dei team interni di Google, il modello mostrerebbe meno disallineamento e meno invenzioni. Sono tutti dati raccolti dall'azienda stessa, e vanno letti come tali.
Per ora Carbon non è aperto a tutti. Da questa settimana lo riceve un gruppo selezionato di professionisti della difesa informatica, tramite il Fairwind Program di Google. L'accesso si allargherà poi in modo graduale ad altri partner fidati, e solo dopo, «il prima possibile», a sviluppatori, aziende e consumatori. Prima, però, Google vuole raccogliere riscontri e affinare le protezioni.
I prezzi sono già noti. Il listino introduttivo, uguale a quello di Argon al lancio, prevede 2 $ per milione di token in input e 10 $ per milione in output, con uno sconto del 95% sull'input in cache. Terminata la fase iniziale, le tariffe saliranno a 4 $ e 20 $ per milione di token. Il nome, del resto, era già trapelato: una schermata di configurazione delle API mostrava la voce gemini-4-carbon-preview, e un checkpoint del modello era comparso su Chatbot Arena.
Il messaggio di Google è chiaro: la prossima frontiera è il software che trova e ripara le falle da solo, per giorni. Prima di affidargli un'infrastruttura, però, i difensori avranno bisogno di verifiche indipendenti, non solo di tabelle compilate da chi il modello lo vende.
Fonti: 9to5google.com, x.com, nokiapoweruser.com
Nessuno ha ancora commentato.