gputaskman: tool open source mostra chi occupa la VRAM della GPU, processo per processo (aggiornato: 6 novembre 2026, ore 17:32)
- a cura di: massimo.valenti
- Commenti:
- Letture:
- Aggiornato: 36 minuti fa
- Pubblicato: 37 minuti fa

Per favore, aggiungi TurboLab.it alle eccezioni del tuo Ad Blocker. Siamo un progetto no-profit, e la pubblicità è indispensabile per pagare le spese.
In alternativa, puoi sostenerci con una donazione.
Rispetteremo ogni tua scelta, e potrai sempre utilizzare il sito senza limitazioni.
Gestione attività di Windows ha un difetto che chiunque abbia caricato un modello di linguaggio in locale conosce bene: mostra quanta memoria della GPU è occupata, ma non dice da chi. Un numero grosso, e basta. Scott Hanselman, vicepresidente di Microsoft e Member of Technical Staff (anche in GitHub), ha deciso di colmare il vuoto con gputaskman, un tool open source che scompone l'uso della VRAM processo per processo e, nel caso degli LLM, prova perfino a capire quale modello stia occupando la scheda video. Con i modelli locali, il browser e il desktop in competizione per pochi gigabyte, sapere chi consuma cosa può fare la differenza tra un rallentamento misterioso e un problema risolto in pochi minuti.
» Download: GPU Task Manager - gputaskman
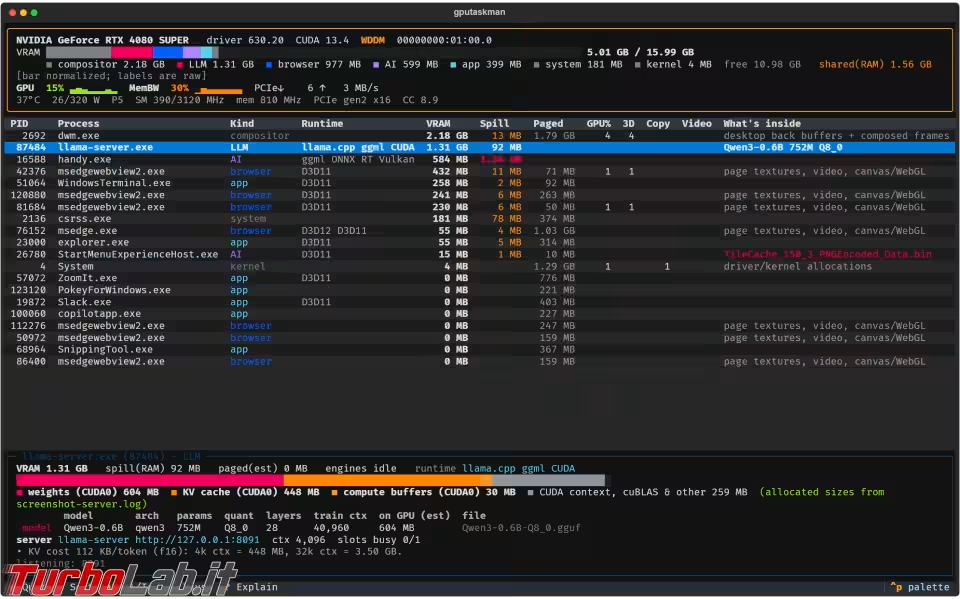
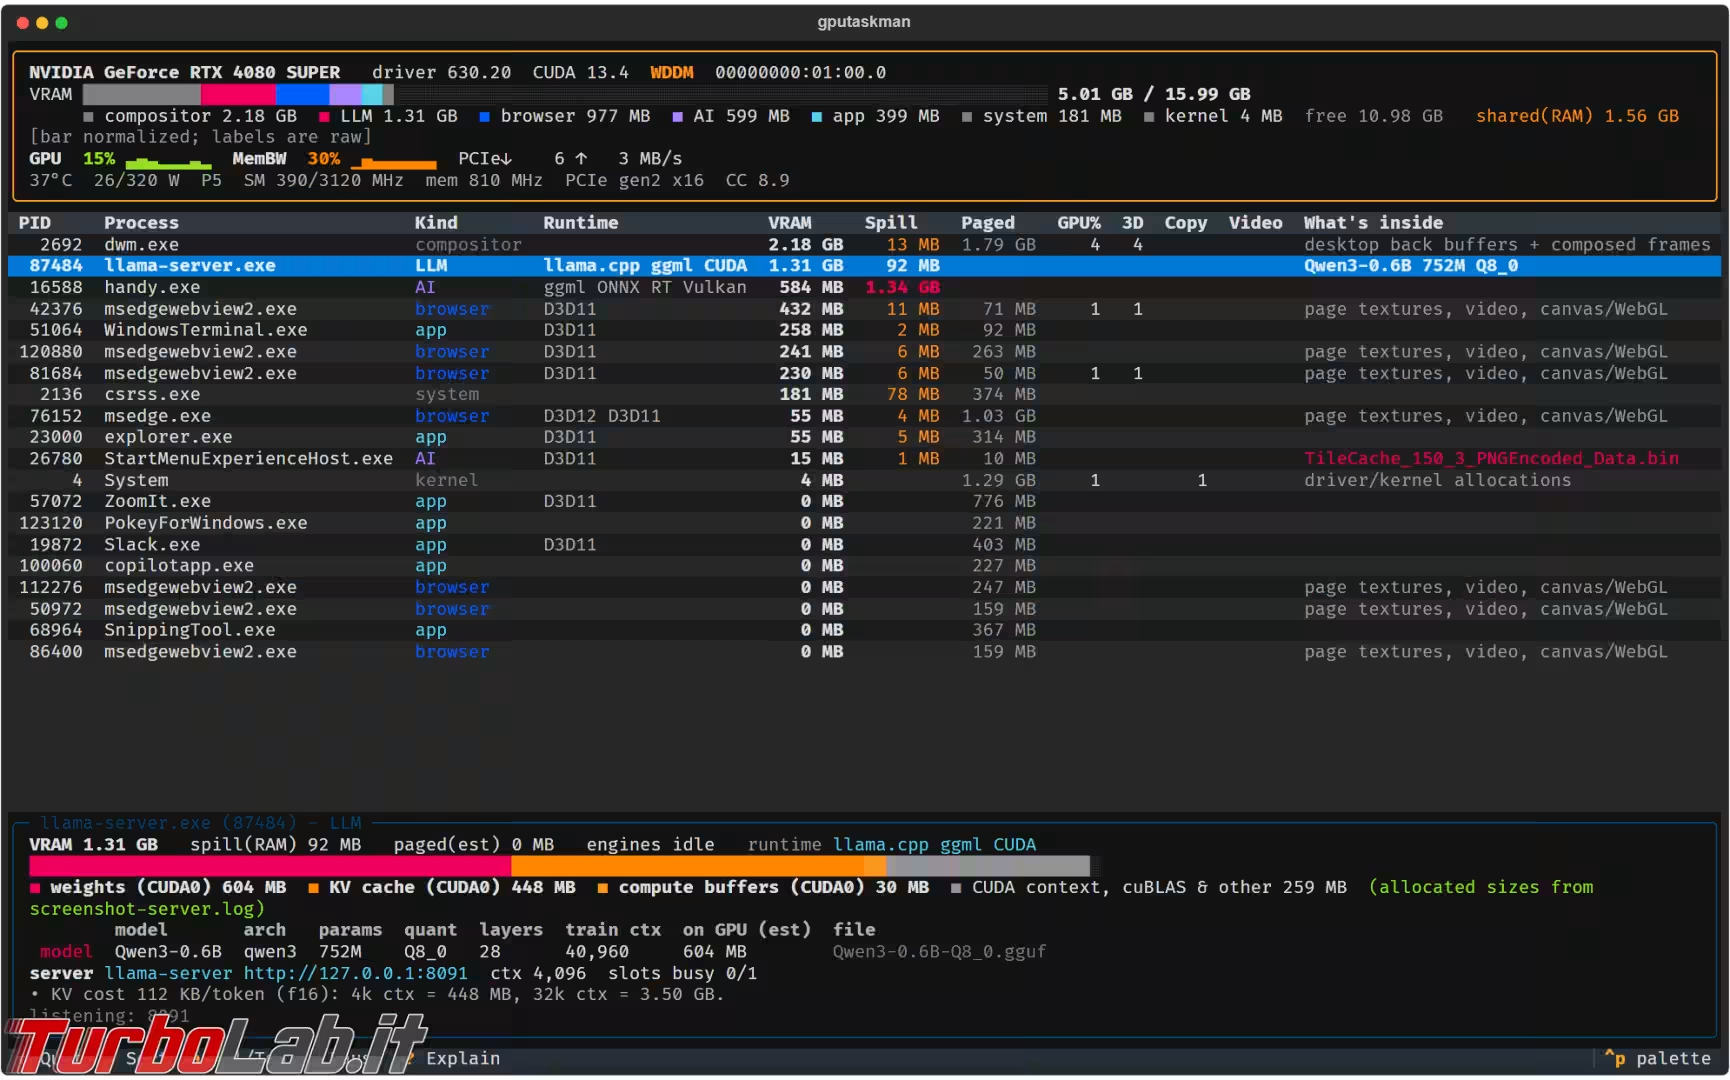
Hanselman lo descrive come un task manager in stile htop per le GPU: una vista su ciò che c'è dentro la scheda video, non solo su quanto è piena. Il problema di partenza lo spiega lui stesso: «Gestione attività dice "15 GB utilizzati". Questo strumento prova a rispondere: da cosa? Pesi del modello? KV cache? Il browser? Il compositore del desktop? E perché così tanta memoria della GPU si trova nella RAM di sistema?».
Si tratta di un'interfaccia testuale da terminale, distribuita con licenza MIT e quindi gratuita. Non è però un prodotto ufficiale di Microsoft né una funzione di Windows: è un progetto personale, pubblicato su GitHub. Lo sviluppo è stato rapidissimo. Le versioni 0.1.0, 0.2.0 e 0.3.0 sono comparse tutte il 3 novembre: la 0.2.0 ha aggiunto il supporto a Linux e WSL, la 0.3.0 quello alle GPU AMD.
Proprio il supporto AMD racconta bene l'aria che si respira nel progetto. È arrivato tramite una pull request della community, sulla quale è intervenuto un bot di triage basato su Copilot per conto di Hanselman, correggendo un bug di scala nelle temperature che rendeva le letture di AMD SMI circa 1.000 volte troppo basse. La modifica è stata provata anche su una Radeon 860M.
La vista del dispositivo riporta uso della VRAM, attività della GPU e della memoria, traffico PCIe, temperatura, consumo, frequenze, attività di encoder e decoder video, il tutto con grafici storici. La vista per processo è quella più interessante: distingue la memoria locale della GPU dalla RAM di sistema accessibile alla GPU, stima il commit non residente, misura l'attività dei vari motori e riconosce i runtime in uso, tra cui CUDA, HIP, Vulkan, Direct3D, ggml e ONNX Runtime.
Per chi lavora con l'AI in locale c'è poi un ispettore dei modelli. Indica quale modello un processo sembra avere caricato e come è stato identificato, l'architettura, la quantizzazione, il numero di layer, la dimensione dei pesi e il costo stimato della KV cache. Con Ollama o LM Studio, gputaskman mostra anche il nome "leggibile" del modello e, quando disponibili, dimensione del contesto, slot occupati e throughput. Chi non usa LLM non resta comunque a mani vuote: il tool mostra quali programmi chiedono rendering grafico o video, e quanta memoria impegnano.
Il punto più apprezzabile del progetto è l'onestà con cui separa ciò che misura da ciò che deduce. Su Windows, la memoria per processo e i contatori dei motori arrivano dal kernel grafico, mentre le metriche del dispositivo provengono da NVML di Nvidia o dalle librerie AMD: questi sono dati misurati. I modelli candidati, invece, vengono ricavati da righe di comando, file mappati in memoria, intestazioni GGUF, API dei server locali e log dei runtime. Una DLL grafica caricata non prova che un processo usi la GPU, e un file di modello mappato non prova che il modello si trovi in VRAM.
Anche la voce "spill", cioè la RAM di sistema accessibile alla GPU, da sola non dimostra che la VRAM sia andata in overflow. Hanselman definisce gputaskman un software sperimentale in fase iniziale: alcune ripartizioni della memoria sono stime, certe letture hardware possono mancare e i carichi di lavoro in cloud restano fuori. Il tool, inoltre, non legge porzioni arbitrarie della memoria video: non identifica le singole texture di un gioco, i tensori o i kernel. Per quello il README rimanda a PIX, Nsight o alla strumentazione specifica dei runtime.
L'esempio nella documentazione chiarisce il concetto. Su una RTX 4080 SUPER, con il llama-server di Docker Model Runner su Vulkan e il modello gemma-3-270m, portare il contesto da 4.096 a 32.768 token produce una stima di 504 MB di KV cache aggiuntiva, ma la memoria dedicata misurata cresce di appena 83 MB. Il README attribuisce lo scarto in parte alla sliding-window attention di Gemma 3 e tratta la stima come un limite superiore. Una macchina e un modello, quindi: un'indicazione utile, non un benchmark.
Su Windows 10 e Windows 11, gputaskman supporta GPU Nvidia e AMD. Su Linux e WSL funziona con le schede Nvidia, mentre su macOS lavora con i chip Apple Silicon. Le letture disponibili cambiano a seconda del sistema operativo e dell'hardware. Le build portabili si scaricano dalla pagina Releases del repository GitHub e non richiedono installazione: basta avviarle.
Chi fa girare LLM sul proprio PC ha così un'indicazione pratica: prima di dare la colpa al modello troppo grande o al driver, conviene controllare se a mangiarsi la VRAM non siano il browser, il compositore del desktop o una KV cache gonfiata da un contesto impostato troppo in alto.
Fonti: windowscentral.com, neowin.net, windowsreport.com, xda-developers.com
Nessuno ha ancora commentato.